Vera Rubin, DeepSeek V4 Pro서 GB300 대비 전성비 최대 5.7배
11일 전
💻 NVIDIA Vera Rubin, AI 추론 전성비 최대 5.7배 우위
AI 인프라 경쟁의 중심이 '최대 연산 성능'에서 '전력당 고속 토큰 생산 능력'으로 확대
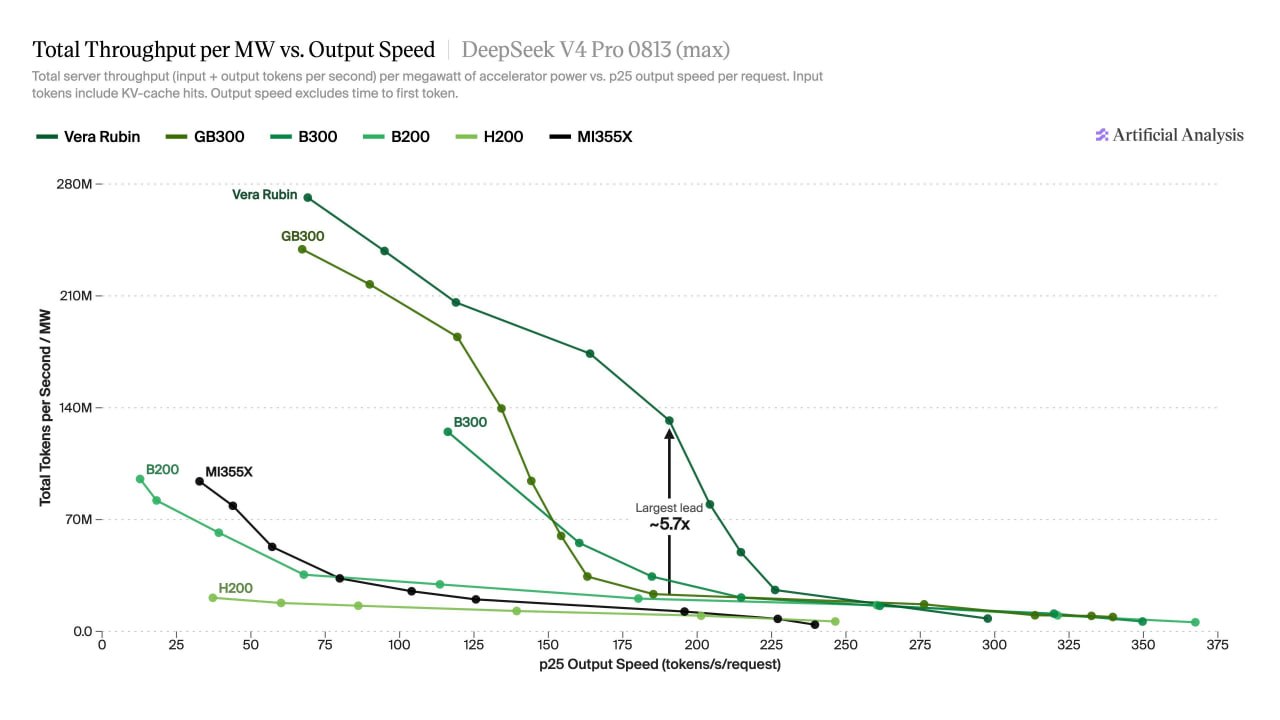
📌 그래프 핵심 지표
X축: 개별 요청당 출력 속도(tokens/s)
Y축: 전력 1MW당 초당 총 처리 토큰 수
우측 상단에 위치할수록 빠른 응답 속도와 높은 전력 효율 확보
📌 ① Vera Rubin: 압도적인 추론 전성비
약 70 tokens/s에서 MW당 약 2.7억 토큰 처리
약 190 tokens/s에서 기존 가속기 대비 최대 5.7배 높은 전력당 처리량
높은 출력 속도에서도 경쟁 제품 대비 우위 유지
동일 전력으로 더 많은 AI 추론 요청을 처리할 수 있는 구조
📌 ② GB300·B300: 시스템 아키텍처의 중요성
GB300은 저속 구간에서 Vera Rubin 다음으로 높은 처리량 기록
150 tokens/s 이상에서는 GB300의 처리량 급감
일부 고속 구간에서는 B300이 GB300의 전성비 역전
시스템 구성과 운영 조건에 따른 추론 효율 차이 확인
📌 ③ B200 vs. AMD MI355X
MI355X는 저속 구간에서 B200과 유사하거나 높은 전성비 기록
고속 구간에서는 B200이 상대적으로 우세
B200은 최대 약 370 tokens/s까지 출력 속도 확장
💻반도체 소부장💻[그로쓰리서치]
https://telegram.me/growth_semi
1
투자 유의사항
모든 투자 의사결정에 대한 책임은 전적으로 투자자 본인에게 있으며, 서비스 내 정보를 활용해 발생한 금전적 손실이나 법적 문제에 대해서 작성자와 당사는 어떠한 법적 책임도 지지 않습니다.